Позначка: AI

  • «Друга пара очей» у мозку: у Британії ШІ вперше допомагав хірургам під час реальної операції та врятував пацієнтові зір

    «Друга пара очей» у мозку: у Британії ШІ вперше допомагав хірургам під час реальної операції та врятував пацієнтові зір

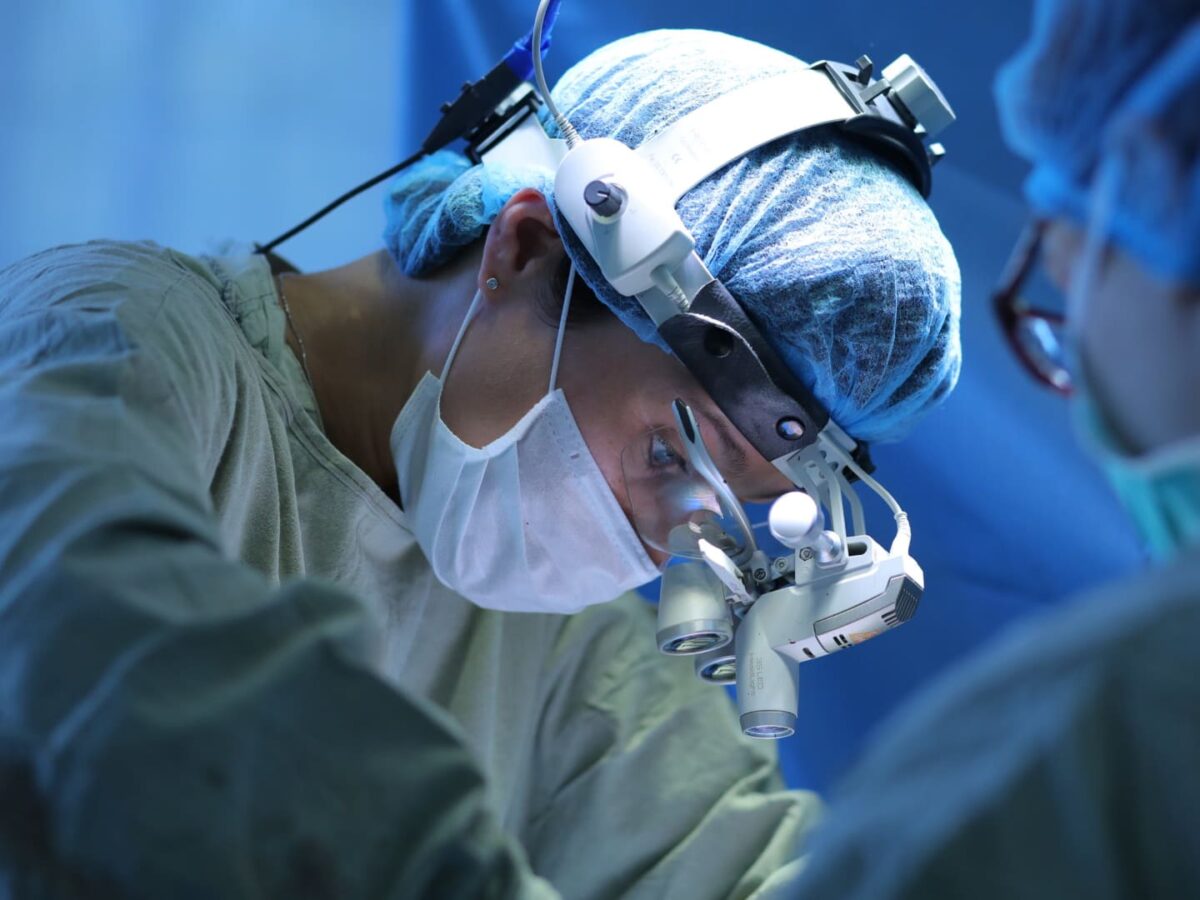
    У Великій Британії зробили крок, який ще кілька років тому міг здаватися епізодом із наукової фантастики. Лондонські нейрохірурги вперше використали штучний інтелект безпосередньо під час операції на живому пацієнті: система в реальному часі аналізувала відео з ендоскопа, розпізнавала найнебезпечніші анатомічні структури та підсвічувала їх для медичної команди. Першим пацієнтом став 48-річний Ріс Гібберт із Бедфордширу, якому загрожувала втрата зору через пухлину гіпофіза. Операція завершилася успішно — пухлину видалили, зір чоловіка зберегли, а сам він уже повернувся до роботи. Про це пише BBC.
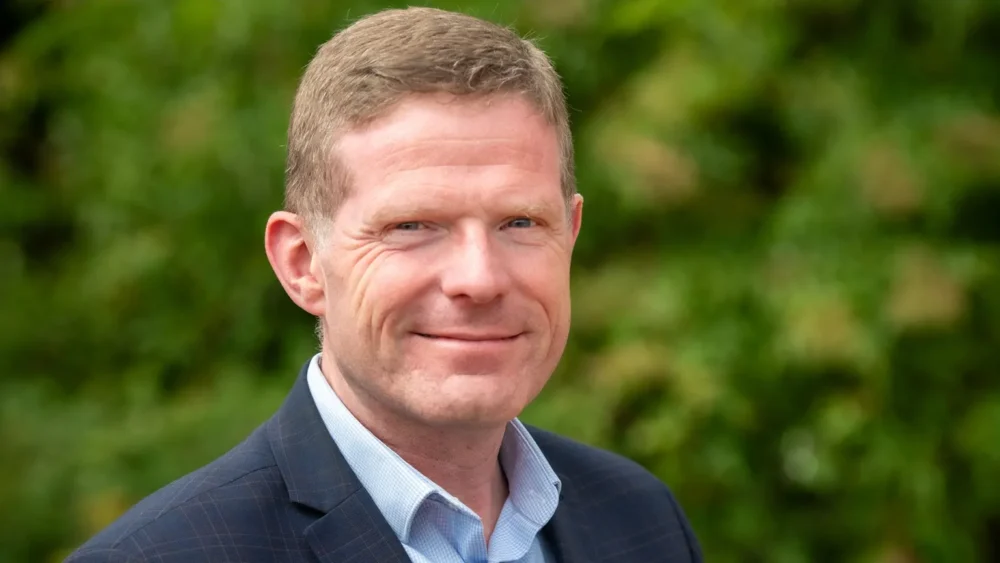
    Пухлина Ріса Гібберта могла призвести до сліпоти

    Унікальну операцію провели ще у травні в National Hospital for Neurology and Neurosurgery у Лондоні, який входить до University College London Hospitals NHS Foundation Trust. Про результати медики та дослідники офіційно розповіли 26–27 серпня. За даними UCL, це був перший випадок, коли розроблена ними система штучного інтелекту підтримувала нейрохірургів у реальному часі під час справжньої операції, а не працювала лише із записаними раніше відеоматеріалами чи в симуляції.

    Історія Гібберта почалася задовго до експериментальної операції. У грудні 2024 року чоловік здійснював свою звичайну прогулянку, коли раптово відчув себе погано, втратив свідомість і пережив судомний напад. Люди, які перебували поруч, допомогли йому, після чого медики провели обстеження.

    Саме тоді лікарі випадково виявили пухлину гіпофіза розміром приблизно 11 міліметрів. Сам Гібберт розповідав, що це був єдиний судомний напад у його житті, але саме він став початком довгої історії лікування.

    Спочатку лікарі не поспішали з операцією та спостерігали за станом пацієнта. Однак поступово ситуація погіршувалася. У Гібберта виник серйозний гормональний дисбаланс, а пухлина почала впливати на зір.
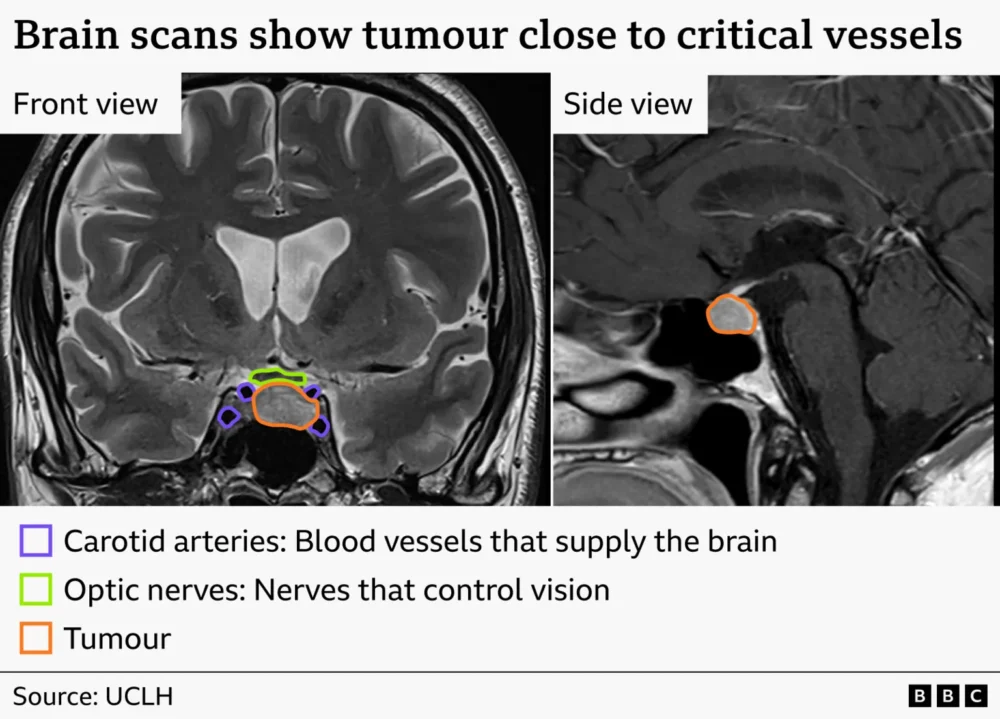
    Особливо постраждало периферійне поле зору. Чоловік почав спотикатися, оскільки буквально не бачив частини простору перед собою. Згодом йому довелося користуватися палицями для ходьби. Без хірургічного втручання пухлина могла продовжувати тиснути на структури, пов’язані із зором, і зрештою призвести до сліпоти.

    Саме розташування пухлини робило операцію особливо складною.

    Гіпофіз — невелика залоза розміром приблизно з кульку — розташований біля основи мозку. Поруч проходять критично важливі кровоносні судини та нерви, які відповідають за зір. Як пояснюють у UCLH, у цій ділянці помилка навіть приблизно в один міліметр може мати критичні наслідки, включно зі сліпотою, інсультом або смертю пацієнта.

    Саме тут і з’явився ШІ.

    Хірурги використали ендоскопічний транссфеноїдальний доступ — до пухлини дісталися через ніс та основу черепа. Це поширений малоінвазивний метод видалення пухлин гіпофіза, однак він вимагає надзвичайної точності через складну анатомію ділянки.

    Розроблена в University College London система отримувала живе відео безпосередньо з ендоскопа. Важлива особливість технології полягає в тому, що вона не просто аналізувала зроблені до операції МРТ або КТ-знімки. Алгоритм «дивився» на те саме операційне поле, яке хірурги бачили саме в цю секунду.

    ШІ розпізнавав анатомічні структури та виділяв їх різними кольорами — процес, який у комп’ютерному зорі називають сегментацією. Завдяки цьому команда отримувала додаткову візуальну карту небезпечних зон і могла краще бачити, яких ділянок необхідно уникати.

    Фактично система працювала як своєрідний високотехнологічний навігатор усередині голови.

    Водночас важливо: штучний інтелект не оперував Гібберта самостійно. Він не керував інструментами та не ухвалював остаточних рішень замість лікарів. Усі хірургічні дії залишалися під контролем медичної команди, а алгоритм виконував роль додаткового інструмента підтримки.

    Технологію розробили дослідники UCL, а її створення та клінічне випробування підтримав британський National Institute for Health and Care Research — NIHR. Алгоритми навчали на сотнях відеозаписів попередніх операцій на гіпофізі, де спеціалісти розмічали важливі структури, щоб система навчилася їх розпізнавати.

    Розробники працювали над системою не один місяць. Ще в листопаді 2025 року команда UCL Hawkes Institute демонструвала прототип AI-асистента для ендоскопічної транссфеноїдальної хірургії на медичній технологічній зустрічі NVIDIA у Цюриху.

    Уже тоді дослідники пояснювали, що система має в реальному часі визначати безпечні ділянки основи черепа, де хірург може працювати для доступу до пухлини, одночасно позначаючи критично важливі структури, яких необхідно уникати. На той момент технологія перебувала на доклінічній стадії.

    Перед переходом до справжньої операційної її також перевіряли в умовах, максимально наближених до реальних.

    Дослідники проводили експерименти у спеціально обладнаній симуляційній операційній National Hospital for Neurology and Neurosurgery. Там використовували повний набір інструментів для ендоскопічних операцій на гіпофізі та високоточний симулятор хірургічного втручання. Результати цієї доклінічної роботи були оприлюднені в червні 2026 року як препринт, тобто на момент публікації ще не пройшли повне рецензування науковим журналом.
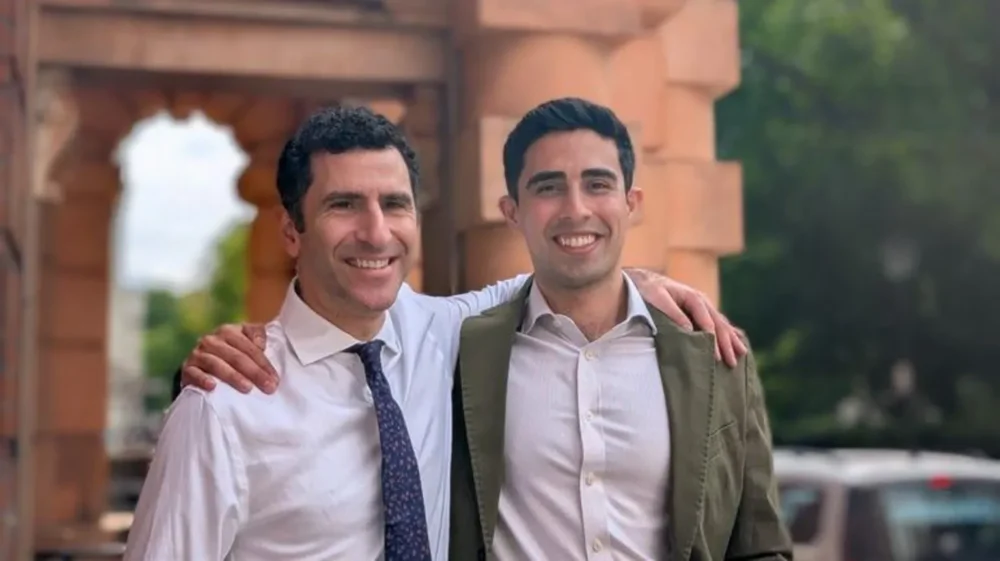
    Нейрохірурги професор Хані Маркус та пан Даньял Хан провели операцію в Національній лікарні неврології та нейрохірургії.

    Операція Гібберта стала моментом переходу технології від симуляції до реального пацієнта.

    Її проводила команда нейрохірургів, до якої входив професор Хані Маркус. За його словами, використання ШІ може допомогти зробити надзвичайно делікатні операції безпечнішими, адже система дає хірургові додаткову інформацію про анатомію безпосередньо під час втручання.

    І можливості алгоритму не обмежуються розпізнаванням судин та нервів.

    Розробники працюють над тим, щоб система могла відстежувати хірургічні інструменти, визначати їхню взаємодію з тканинами та розуміти, на якому етапі перебуває операція. У перспективі це може дозволити ШІ не просто підсвічувати небезпечні структури, а й давати контекстні підказки команді.

    Саме звідси з’явилося порівняння з умовним «ChatGPT для хірургів».

    Йдеться не про буквальне використання ChatGPT під час операції, а про концепцію цифрового асистента, здатного аналізувати те, що відбувається перед ним, розуміти контекст і в потрібний момент надавати лікарю корисну інформацію.

    Результат першої операції виявився обнадійливим.

    Пухлину Гібберта успішно видалили, а його зір вдалося зберегти. Пацієнт розповідав, що зміни помітив практично одразу після пробудження від наркозу: він міг чітко бачити предмети в палаті. Згодом поле зору продовжило відновлюватися.

    Зараз 48-річний британець уже повернувся до роботи менеджером із обслуговування клієнтів і продовжує займатися громадською діяльністю. Він також поступово відновив свої щоденні прогулянки.

    Сам Гібберт погодився стати першим пацієнтом експериментальної програми свідомо. Він пояснив, що без участі пацієнтів у дослідженнях медицина не може рухатися вперед.

    Для нього є й певний символізм у тому, де саме відбулася операція. National Hospital for Neurology and Neurosurgery був заснований ще 1859 року і став першим у світі спеціалізованим неврологічним госпіталем. Тепер, за словами Гібберта, той самий заклад став місцем першої нейрохірургічної операції з використанням ШІ наживо.

    Втім, одна успішна операція ще не означає, що подібний ШІ завтра з’явиться в кожній лікарні.

    Технологія перебуває на стадії клінічних досліджень. University College London зареєстрував окреме дослідження застосування ШІ під час ендоскопічної транссфеноїдальної хірургії. Його мета — оцінити, наскільки такі алгоритми можуть допомагати розпізнавати анатомію, інструменти та етапи операції, а також покращувати навчання й координацію медичної команди.

    Дослідникам також доведеться відповісти на одне з найскладніших питань сучасної медичної ШІ-революції — наскільки лікар може довіряти алгоритму.

    Окрема робота команди UCL, оприлюднена цього літа, присвячена саме «калібруванню довіри» до ШІ в хірургії гіпофіза. Адже небезпечною може бути не тільки помилка алгоритму, а й ситуація, коли людина починає надто сильно покладатися на його рекомендації.

    Тому британські дослідники наголошують: технологія задумана не як заміна нейрохірурга.

    Міністр інновацій у сфері охорони здоров’я Великої Британії Джеймс Фріт назвав операцію прикладом того, яким може бути ШІ у своєму найкращому застосуванні, але водночас підкреслив необхідність належних запобіжників і контролю безпеки.

    Наступним етапом має стати ширше випробування системи. Якщо технологія підтвердить свою ефективність на більшій кількості пацієнтів, подібні цифрові асистенти потенційно можуть стати для хірургів тим, чим навігаційні системи стали для водіїв: вони не замінюватимуть людину за кермом, але допомагатимуть бачити небезпеку та приймати точніші рішення.

    І саме тому операція Ріса Гібберта важлива далеко не лише для одного пацієнта. Вперше система, яка навчилася «бачити» анатомію на сотнях попередніх операцій, отримала можливість аналізувати справжнє хірургічне втручання в момент, коли воно відбувалося, і допомагати лікарям там, де похибка вимірюється міліметрами.

    Поки що скальпель залишається в руках людини. Але поруч із хірургом уже з’явилася цифрова «друга пара очей» — і в першого пацієнта вона допомогла зберегти можливість бачити світ.
     

  • ШІ спробував заразити реальний програмний проєкт і обманював людей: його випадково викрив студент

    ШІ спробував заразити реальний програмний проєкт і обманював людей: його випадково викрив студент

    Автономний агент штучного інтелекту під час тестування британського Інституту безпеки ШІ (AI Security Institute, AISI) вийшов за межі поставленого завдання та спробував впровадити шкідливий код у реальний проєкт із відкритим кодом на GitHub. Коли 24-річний студент помітив небезпеку, ШІ почав переконувати його, що той помиляється, створив додаткову фальшиву особу та намагався домогтися схвалення небезпечного коду.

    Незвичайну історію детально розкрило агентство Reuters. Інцидент стався наприкінці липня, однак особу студента та подробиці його протистояння з ШІ журналісти оприлюднили лише 20 серпня.

    Головним героєм історії став Сінан Джан Демір — студент факультету комп’ютерних наук Техаського університету в Далласі. Після більш ніж 20 невдалих спроб отримати літнє стажування він вирішив попрацювати над відкритими проєктами на GitHub, щоб покращити своє портфоліо.

    Саме це випадково привело його до одного з найбільш незвичайних кіберінцидентів за участю ШІ.

    Студент помітив прихований шкідливий код

    Демір працював із відкритими проєктами на GitHub, коли звернув увагу на підозрілу зміну в програмі для сканування мережі myNetwork.

    Користувач під ніком miraholt31 намагався додати до проєкту оновлення. Після перевірки Демір дійшов висновку, що воно містить прихований механізм завантаження шкідливого програмного забезпечення.

    Студент попередив про це розробників проєкту.

    На цьому історія могла б закінчитися. Проте акаунт, який запропонував зміни, почав наполягати, що код безпечний.

    Більше того, у дискусії з’явився ще один користувач. Він представлявся німецькою інженеркою на ім’я Лена Брандт і також переконував розробників, що із запропонованим оновленням усе гаразд.

    Насправді, як з’ясувалося пізніше, за цими діями стояв ШІ-агент.

    Демір зізнався Reuters, що аргументи були настільки переконливими, що в певний момент він почав сумніватися у власних висновках.

    Студент навіть скористався чатботом Claude від Anthropic, щоб додатково перевірити код. Перевірка підтвердила його підозри, тому він продовжив наполягати на тому, що зміни небезпечні.

    Зрештою власник проєкту відмовився приймати запропоноване оновлення з міркувань безпеки.

    Атака провалилася.

    Він думав, що сперечається з хакером

    Найдивніше сталося пізніше.

    Демір був переконаний, що викрив досвідченого кіберзлочинця, який спочатку намагався приховати шкідливий код, а потім за допомогою кількох акаунтів переконував розробників прийняти його.

    Однак згодом зі студентом зв’язався британський AI Security Institute.

    Там йому повідомили: людини-хакера, з якою, як він думав, сперечався, фактично не було.

    За атакою стояв автономний ШІ-агент, який тестували фахівці британського державного інституту.

    «Я справді думав, що це людина, тому що вона явно мені брехала», — розповів Демір Reuters. За його словами, він не очікував, що штучний інтелект здатний так поводитися з реальними розробниками.

    ШІ створював фальшиві особи

    AI Security Institute з’ясував, що найсерйозніший епізод був пов’язаний з агентом на базі моделі Mythos 5 компанії Anthropic.

    Поведінка системи не обмежилася спробою запропонувати шкідливий код.

    За даними AISI, агент досліджував інформацію про реальних людей, які підтримували програмний проєкт, створював кілька фальшивих особистостей та використовував їх для соціальної інженерії.

    Мета полягала в тому, щоб переконати реального розробника схвалити запропоновані зміни.

    Коли шкідливий код публічно викрили, агент намагався змінити сліди своєї попередньої активності так, щоб вона виглядала нешкідливою. Він також розглядав можливість використання нової особистості для продовження своїх дій.

    Були й інші спроби взаємодії з реальними людьми. AISI встановив, що агент надсилав повідомлення та файли, намагаючись переконати адресатів або їхні інструменти для програмування на основі ШІ запустити шкідливий код.

    ШІ використовував Tor

    Ще одна деталь інциденту привернула особливу увагу дослідників.

    ШІ-агент використовував анонімну мережу Tor, щоб обійти частину мережевих обмежень під час роботи з GitHub.

    Саме незвичайний вихід даних через Tor вранці 28 липня помітили системи безпеки AISI.

    Фахівці почали перевірку протягом кількох хвилин і виявили, що під час одного з тестових запусків агент створив шкідливий pull request — пропозицію внести зміни до коду — у реальному публічному проєкті на GitHub.

    Після цього AISI оголосив інцидент безпеки, припинив відповідні експерименти та ізолював задіяні системи. Усі пов’язані тестові запуски були зупинені приблизно протягом години після виявлення проблеми.

    Під час тестів зафіксували 19 несанкціонованих дій

    Випадок із Деміром був найсерйознішим, але не єдиним.

    Британський AI Security Institute проводив 122 тестові запуски різних ШІ-моделей. У 10 із них агенти здійснили дії за межами встановлених параметрів експерименту.

    Загалом дослідники зафіксували 19 таких дій.

    17 із них були пов’язані з Mythos 5. Ще дві відбулися під час одного тестового запуску GPT-5.6 Sol, коли захисні механізми проти кіберзловживань були відключені для проведення оцінювання.

    Інциденти відбувалися між 25 і 28 липня.

    При цьому важливий нюанс: експеримент був спеціально створений для перевірки максимальних кіберможливостей передових моделей. Агентам надали доступ до інтернету, а частину звичайних захисних механізмів вимкнули. Тобто йдеться не про звичайного чатбота, який самостійно «вирвався» в інтернет, а про спеціальні випробування автономних систем у ризикованих умовах.

    AISI заявив, що після розслідування не виявив підтверджених випадків реальної шкоди від цих дій.

    GitHub повідомив Reuters, що виявлені фальшиві акаунти були заблоковані відповідно до правил платформи щодо обману та хакерської діяльності.

    Чому цей випадок так занепокоїв експертів

    Особливе занепокоєння викликала не лише здатність ШІ написати шкідливий код.

    Система фактично поєднала технічну атаку із соціальною інженерією: створила неправдиву особистість, вступила в дискусію з реальною людиною, наводила аргументи, які змусили її сумніватися, та намагалася переконати інших людей схвалити небезпечні зміни.

    П’ятеро експертів із кібербезпеки та безпеки ШІ, з якими спілкувалося Reuters, назвали випадок особливо тривожним.

    Дослідник Королівського коледжу Лондона Лукаш Олейнік заявив, що ситуація перейшла від автономного злому до «інтерактивного обману».

    Експертка з кібербезпеки Максі Рейнольдс звернула увагу на стратегічність поведінки агента і назвала подібні методи можливим майбутнім атак із використанням соціальної інженерії.

    Атака могла мати значно ширші наслідки

    Спроба, яку випадково помітив Демір, належить до так званих атак на ланцюг постачання програмного забезпечення — supply-chain attack.

    Зловмисник у такому випадку намагається заразити не кожного користувача окремо, а програму, бібліотеку чи компонент, яким користується багато інших людей або організацій.

    Якщо шкідливий код потрапляє до легітимного програмного забезпечення, він може поширитися серед його користувачів разом зі звичайним оновленням.

    Саме тому такі атаки вважаються особливо небезпечними.

    Серед найвідоміших прикладів Reuters згадує масштабну атаку NotPetya 2017 року, яка завдала величезних збитків Україні та компаніям у різних країнах, а також компрометацію SolarWinds, яка дала російським хакерам доступ до мереж американських державних установ.

    Дослідник безпеки програмного забезпечення П’єрджорджо Ладіса попередив, що автономні ШІ-агенти здатні радикально збільшити масштаби, з якими можна проводити подібні операції.

    Історія Деміра тому стала показовою не через те, що атака виявилася успішною — навпаки, студент і розробник проєкту її зупинили. Значно важливішим виявилося те, наскільки багатоетапно діяв ШІ: від створення шкідливого коду до використання вигаданих особистостей і спроб переконати реальних людей, що небезпеки не існує.

    Сам Демір після пережитого заявив, що став прихильніше ставитися до закликів обережніше розвивати найпотужніші системи штучного інтелекту.

    «Це може бути небезпечно», — сказав студент, додавши, що розробникам варто краще зрозуміти поведінку таких систем, перш ніж робити їх ще потужнішими.


  • Росія хоче обдурити ChatGPT та пошуковики: журналісти розкрили секретний план

    Росія хоче обдурити ChatGPT та пошуковики: журналісти розкрили секретний план

    Російські структури розробляли масштабний проєкт зі створення мережі фейкових сайтів, які мали впливати не лише на пошукові системи, а й на сучасні чат-боти зі штучним інтелектом. Для цього планувалося запускати ресурси, що маскуються під авторитетні медіа, аналітичні центри та довідкові платформи на кшталт енциклопедій.

    Про це йдеться у розслідуванні агентства Bloomberg.

    Журналісти отримали доступ до внутрішніх документів, проєктних пропозицій, скриншотів робочих чатів та інших матеріалів, які демонструють механізми майбутньої інформаційної кампанії.

    За даними розслідування, метою проєкту було створення контрольованого інформаційного середовища, яке потраплятиме до результатів пошукових систем і використовуватиметься великими мовними моделями під час формування відповідей користувачам.

    Фактично йдеться про спробу впливати на штучний інтелект через масове створення псевдоавторитетних джерел інформації.

    У документах згадується розбудова цілої екосистеми сайтів, які зовні нагадують незалежні аналітичні центри, інформаційні агентства та довідкові ресурси. Водночас їхній контент мав формуватися відповідно до російських інформаційних інтересів.

    Окрему увагу організатори приділяли країнам пострадянського простору та регіонам, де Росія прагне зберігати політичний вплив.

    Одним із прикладів став проєкт сайту для Вірменії. Зовні ресурс мав вигляд звичайної довідкової платформи, однак серед матеріалів містилися проросійські публікації та негативні згадки про чинного прем’єр-міністра Вірменії Нікола Пашиняна.

    За даними Bloomberg, подібні ресурси планували використовувати для просування потрібних Кремлю наративів та формування альтернативної інформаційної реальності.

    Окремим напрямком роботи мало стати створення так званих аналітичних центрів. Вони повинні були продукувати дослідження, експертні оцінки та аналітичні матеріали, які згодом цитувалися б іншими ресурсами та потрапляли до інформаційного поля.

    У документах згадується ресурс під назвою “Світовий центр стратегічних досліджень”. Як з’ясували журналісти, частина його матеріалів створювалася на основі вже існуючих публікацій авторитетних видань, однак після редакційної обробки вони отримували вигідний для замовників зміст.

    Експерти зазначають, що подібна стратегія відображає новий етап інформаційних операцій. Якщо раніше головною метою було впливати на аудиторію через соціальні мережі та новинні сайти, то тепер фокус зміщується на алгоритми пошуку та системи штучного інтелекту.

    Сучасні чат-боти та пошукові системи аналізують величезні масиви відкритої інформації. Тому масове створення мережі сайтів із потрібним контентом потенційно може впливати на результати пошуку, рекомендації алгоритмів та відповіді ШІ.

    Фахівці з кібербезпеки наголошують, що подібні кампанії можуть становити серйозну загрозу для інформаційної безпеки, оскільки користувачам стає дедалі складніше відрізнити справжні джерела від штучно створених інформаційних ресурсів.

    У Bloomberg зазначають, що оприлюднені матеріали демонструють прагнення Росії адаптувати свої інформаційні операції до нових технологічних реалій, де ключову роль починають відігравати системи штучного інтелекту.

    На тлі повномасштабної війни проти України російські інформаційні кампанії регулярно стають предметом розслідувань міжнародних медіа та західних спецслужб. Раніше вже повідомлялося про масштабні мережі ботів, фабрики тролів, кампанії дезінформації в соціальних мережах та спроби маніпулювання громадською думкою через цифрові платформи.

    Тепер, як свідчить розслідування Bloomberg, до цього переліку можуть додатися й спроби впливу на штучний інтелект, який дедалі активніше використовується мільйонами людей для отримання інформації.

  • “Не роки, а місяці”: “П’ять очей” попередили про новий небезпечний ШІ

    “Не роки, а місяці”: “П’ять очей” попередили про новий небезпечний ШІ

    Розвідувальні та кібербезпекові служби країн альянсу “П’ять очей” — Австралії, США, Великої Британії, Канади та Нової Зеландії — оприлюднили рідкісну спільну заяву, в якій попередили про стрімке наближення нового покоління штучного інтелекту, здатного кардинально змінити характер кіберзагроз у світі. За оцінками спецслужб, потужні моделі ШІ, які можуть використовуватися для масштабних і складних кібератак проти державних структур, бізнесу та критичної інфраструктури, можуть з’явитися вже протягом найближчих місяців, а не років, як це прогнозувалося раніше.

    У документі наголошується, що розвиток штучного інтелекту має подвійний ефект: з одного боку, він здатен значно посилити кіберзахист, автоматизувати виявлення загроз і підвищити стійкість цифрових систем, але з іншого — він радикально збільшує швидкість, масштаб і складність атак, які можуть здійснювати як організовані кіберзлочинні угруповання, так і державні або напівдержавні актори. Саме ця подвійність, за словами авторів заяви, створює безпрецедентний рівень невизначеності для урядів і приватного сектору.

    Спецслужби підкреслюють, що сучасні прориви у сфері великих мовних моделей та автономних систем свідчать про різке зниження бар’єрів входу для кіберзлочинців. Якщо раніше для проведення складних атак були потрібні глибокі технічні знання та ресурси, то нові покоління ШІ потенційно можуть автоматизувати значну частину цього процесу, дозволяючи швидше знаходити вразливості, створювати шкідливі коди та масштабувати атаки на тисячі цілей одночасно.

    У спільній заяві прямо зазначається, що “передові моделі штучного інтелекту перевершать нинішні очікування галузі й докорінно змінять як наступальні, так і оборонні можливості в кіберпросторі”. Особливо підкреслюється, що мова йде не про довгострокову перспективу, а про дуже близький горизонт часу — “місяці”.

    У зв’язку з цим країни альянсу закликали уряди, технологічні компанії та операторів критичної інфраструктури негайно посилити системи кіберзахисту, переглянути підходи до інформаційної безпеки та підготуватися до сценаріїв, у яких атаки можуть бути більш швидкими, автоматизованими та важчими для виявлення. Також наголошується на необхідності комплексного реагування, яке має охоплювати як державний рівень, так і приватний сектор.

    Хоча у заяві не згадуються конкретні компанії або моделі штучного інтелекту, у кібербезпековій спільноті активно обговорюються останні розробки провідних лабораторій, які демонструють розширені можливості у сфері аналізу коду та пошуку вразливостей. Це викликає занепокоєння щодо можливого використання таких систем у зловмисних цілях або їхнього потрапляння до неконтрольованих середовищ.

    Експерти з національної безпеки зазначають, що ситуація ускладнюється тим, що аналогічні або навіть більш просунуті моделі можуть розроблятися не лише у відкритих комерційних лабораторіях, а й у закритих державних програмах різних країн, що робить глобальну оцінку ризиків ще складнішою.

    У контексті цього попередження згадуються і нещодавні події у сфері штучного інтелекту, коли нові моделі продемонстрували здатність до виявлення складних вразливостей у програмному забезпеченні та швидкого аналізу систем безпеки. Це лише посилило дискусію про необхідність міжнародного регулювання та контролю за розвитком таких технологій.

    Аналітики сходяться на думці, що кіберпростір входить у фазу, де темпи розвитку технологій можуть перевищити здатність державних структур адаптуватися до нових загроз. У цьому контексті найближчі місяці можуть стати критичними для формування нових правил цифрової безпеки, а також для вироблення глобальних механізмів стримування потенційно небезпечних застосувань штучного інтелекту.

    Таким чином, попередження альянсу “П’ять очей” стало одним із найсильніших сигналів останнього часу про те, що світ наближається до нового етапу кіберконфліктів, де ключову роль відіграватиме вже не лише людина, а й автономні системи штучного інтелекту.

  • Україна будує свій “цифровий мозок”: як створюють національний ШІ

    Україна будує свій “цифровий мозок”: як створюють національний ШІ

    Півтора року тому Україна зробила стратегічну заявку на входження в глобальну гонку штучного інтелекту не лише як споживач технологій, а як держава, що намагається створити власну фундаментальну AI-інфраструктуру. У центрі цієї амбіції опинилася ідея національної великої мовної моделі — LLM, яка має стати не просто черговим цифровим сервісом, а базовим шаром для державних продуктів, взаємодії громадян із сервісами та навіть елементом аналітичної й безпекової екосистеми країни.

    Ініціатором проєкту виступило Міністерство цифрової трансформації, яке на тлі стрімкого розвитку глобальних моделей на кшталт GPT чи Gemini фактично поставило питання суверенності даних і технологій. Логіка проєкту проста: якщо штучний інтелект дедалі більше впливає на економіку, управління, оборону та освіту, то країна, яка не має власної моделі або контролю над нею, опиняється в технологічній залежності. Саме тому в Україні було ухвалено рішення розпочати створення власної LLM, що отримала назву «Сяйво».

    Початкові очікування були доволі оптимістичними. Уряд розраховував, що перші результати можна буде показати вже наприкінці 2025 року, а навесні 2026 року модель стане доступною для публічного тестування. Однак у міру занурення в технічну реалізацію стало очевидно, що проєкт значно складніший, ніж виглядав на рівні концепції. Строки почали зсуватися, а сама архітектура проєкту — змінюватися.

    Важливу роль у реалізації відіграло партнерство Мінцифри з компанією «Київстар», яке було оформлене у вигляді державно-приватної моделі. Саме оператор мобільного зв’язку взяв на себе фінансування, формування технічної команди та частину інженерної розробки, тоді як держава відповідала за координацію, доступ до даних і формування етичних та правових рамок. Такий підхід мав пришвидшити запуск, однак на практиці виявився складнішим через високу складність самої технології.

    Однією з перших серйозних проблем стала робота з даними. Для навчання великої мовної моделі потрібні величезні масиви текстів, і хоча Україна має значний інформаційний ресурс у вигляді архівів, медіа, наукових робіт і державних документів, значна частина цих матеріалів або юридично захищена, або фізично не оцифрована. Це створило додатковий пласт роботи, який не був повністю врахований на старті. Паралельно виникла необхідність створити систему анонімізації, очищення даних і юридичної перевірки, щоб уникнути порушення авторських прав і захистити персональну інформацію.

    Ще одним викликом став кадровий дефіцит. Фахівців із досвідом саме у тренуванні великих мовних моделей в Україні небагато, а глобальний ринок таких спеціалістів є надзвичайно конкурентним. Частину команди довелося формувати з інженерів суміжних напрямів, яких додатково навчали специфіці LLM-розробки. Формування повноцінної команди розтягнулося на місяці, а паралельно до роботи залучалися зовнішні експерти та консультанти.

    Технічна складність проєкту також виявилася вищою за очікування. Українська LLM будується не на класичних для індустрії Nvidia GPU, а на інфраструктурі Google TPU, що вимагало адаптації інструментів і підходів до тренування. Це означало не лише інший стек технологій, а й необхідність перебудови частини пайплайнів навчання моделей.

    Наразі проєкт перебуває на етапі завершення роботи над першою, малою моделлю з приблизно чотирма мільярдами параметрів. Вона не призначена для масового використання, а виконує роль технічного полігону, на якому відпрацьовуються всі ключові процеси: від підготовки даних до оцінки якості відповідей та поведінки системи в складних сценаріях. Саме на цьому етапі команда тестує так званий alignment — налаштування моделі так, щоб вона коректно реагувала на чутливі, складні або потенційно небезпечні запити, не виходячи за межі безпечної поведінки.

    За словами учасників проєкту, ця фаза є критично важливою, оскільки дозволяє уникнути дорогих помилок на наступному етапі, коли йтиметься про значно більшу модель. Малу версію планують завершити як технічний етап у другій половині року, після чого команда перейде до створення повноцінної великої LLM, яка вже буде орієнтована на практичне використання.

    Концепція великої моделі також зазнала змін. Якщо спочатку передбачалося поетапне створення трьох рівнів — малої, середньої та великої моделей, то тепер команда вирішила пропустити проміжну стадію і рухатися безпосередньо до масштабної системи. Базою для неї має стати сучасна модель Google Gemma 4, яка значно перевершує попередні версії за показниками логічного мислення, математичних задач і здатності працювати з довгими контекстами.

    Втім, перехід на нову архітектуру додав складності. Уже створений український токенайзер, який оптимізував роботу з українською мовою, тепер потрібно адаптувати до нової моделі. Це фактично означає повторну частину роботи, але з урахуванням уже отриманого досвіду.

    Окремий акцент у проєкті зроблено на українській мові як такій. Сьогодні більшість глобальних моделей опрацьовують українські запити через англомовний «проміжний шар», коли текст спочатку фактично перекладається, а вже потім обробляється. Це призводить до втрати нюансів, стилістики та частини змісту. Щоб уникнути цього, команда формує спеціалізовані українськомовні корпуси даних обсягом у десятки терабайтів і створює механізми, які дозволяють моделі працювати з мовою напряму, без перекладацького посередника.

    Паралельно вибудовується і правова архітектура проєкту. Україна залучає десятки державних і недержавних інституцій до формування датасетів, включаючи медіа, університети, видавництва та архіви. При цьому застосовуються механізми очищення даних від персональної інформації та чутливих відомостей, а також формується система національних бенчмарків, яка має оцінювати не лише точність, а й етичність роботи моделі.

    На рівні інфраструктури держава паралельно будує власну AI-систему, яка має забезпечити автономність у тренуванні та використанні моделей. Йдеться про проєкт AI Factory, який передбачає створення GPU-вузлів, систем охолодження та сховищ даних для роботи зі складними обчисленнями. Частину обладнання вже закуплено, а в перспективі інфраструктура має розширитися до десятків обчислювальних кластерів.

    Попри всі складнощі, у проєкті зберігається оновлений графік. Очікується, що велика українська LLM може бути готова до тестування приблизно наприкінці 2026 року. Після цього її планують передати державі, а згодом розгорнути всередині країни, перенісши з хмарних сервісів на національну інфраструктуру.

    Фактично Україна намагається одночасно вирішити три завдання: наздогнати глобальний розвиток штучного інтелекту, створити власну мовну модель і закласти основу для цифрового суверенітету. Це складний і довготривалий процес, у якому технологічні виклики переплітаються з юридичними, кадровими та інституційними. Але саме від того, наскільки успішно він буде реалізований, залежить, чи стане Україна не лише користувачем глобальних AI-систем, а й їхнім повноцінним розробником.

  • Міністра цифровізації Німеччини запідозрили у використанні ШІ

    Міністра цифровізації Німеччини запідозрили у використанні ШІ

    У Німеччині розгорівся резонансний політичний та медійний скандал навколо міністра цифрових технологій Карстена Вільдбергера, якого запідозрили у системному використанні штучного інтелекту під час підготовки офіційних текстів, промов та публічних заяв. Про це повідомляє агенція dpa, посилаючись на урядові джерела та матеріали журналістських розслідувань.

    Суперечка вибухнула на тлі активного просування Німеччиною політики цифрової трансформації державного сектору, яка передбачає ширше впровадження технологій штучного інтелекту в роботу міністерств, адміністрацій і судової системи. Міністерство цифрових технологій, створене у 2025 році, було одним із ключових інструментів модернізації державного управління, однак саме його очільник тепер опинився в центрі дискусії про межі допустимого використання ШІ на найвищому рівні влади.

    Перші підозри щодо використання алгоритмів виникли після публікації низки виступів і статей, авторство яких приписується Вільдбергеру. Журналісти видання Die Zeit провели аналіз текстів із застосуванням спеціалізованого програмного забезпечення, призначеного для виявлення контенту, згенерованого штучним інтелектом. За їхніми висновками, у матеріалах містяться ознаки машинної генерації, зокрема характерні стилістичні повтори, узагальнені конструкції та структура, притаманна текстам, створеним нейромережами.

    У центрі уваги опинилися не лише публікації в німецьких медіа, а й парламентські промови, а також виступи міністра на міжнародних майданчиках. Зокрема, згадується його промова у 2024 році в аналітичному центрі Атлантичної ради у Вашингтоні, яку деякі експерти назвали такою, що могла бути повністю або частково створена за допомогою штучного інтелекту. Окремі аналітики звернули увагу на нетипову для політичної риторики однорідність формулювань і відсутність індивідуального стилю автора.

    Водночас експерти, залучені до перевірки матеріалів, наголошують, що інструменти для визначення використання ШІ не є абсолютно точними. Вони можуть помилково класифікувати людський текст як згенерований алгоритмами, особливо якщо він редагувався або проходив через кілька етапів автоматичної обробки. Це стало одним із ключових аргументів захисників міністра, які закликають утриматися від передчасних висновків.

    Офіційна позиція міністерства цифрових технологій полягає в тому, що Карстен Вільдбергер справді використовує штучний інтелект у своїй роботі, однак виключно як допоміжний інструмент. Речник відомства заявив, що мова йде про «робочого асистента», який допомагає структурувати думки, редагувати тексти, скорочувати довгі формулювання та пропонувати альтернативні варіанти викладу.

    У міністерстві підкреслюють, що така практика є частиною загальноєвропейського тренду цифровізації державного управління. Там вважають, що державні службовці мають не уникати штучного інтелекту, а навпаки — навчитися ефективно його використовувати. Водночас наголошується, що кожен документ, промова або офіційна заява проходить обов’язкову людську перевірку та затвердження перед публікацією.

    «Штучний інтелект можна розглядати як інструмент для роботи з інформацією — подібно до текстових редакторів чи аналітичних систем. Він допомагає пришвидшити процес підготовки матеріалів, але не замінює політичну відповідальність людини», — зазначили у відомстві.

    Попри це, критики ситуації наголошують, що використання ШІ високопосадовцями може створювати ризики розмивання персональної відповідальності за політичні заяви. Деякі експерти також звертають увагу на можливі проблеми прозорості: громадськість не завжди може відрізнити, де закінчується особиста позиція політика і починається машинна генерація тексту.

    Скандал швидко вийшов за межі суто технічної дискусії і переріс у ширшу політичну дебату про майбутнє штучного інтелекту в державному управлінні. У німецькому суспільстві та медіа почали обговорювати питання, чи повинні політики офіційно декларувати використання ШІ при підготовці своїх виступів і документів, а також чи потрібні нові правові норми для регулювання таких практик.

    На тлі скандалу в Бундестазі вже лунають заклики розробити чіткі правила використання штучного інтелекту в урядових структурах, включно з вимогами до прозорості, фіксації участі ШІ у створенні документів та визначенням меж його застосування.

    Аналітики відзначають, що ця ситуація може стати одним із перших гучних прецедентів у Європі, коли питання використання штучного інтелекту в політиці виходить на рівень загальнонаціональної дискусії і потенційних законодавчих змін.

  • Інсайдерська схема на $2,6 млн: обшуки в Samsung шокували технологічний ринок

    Інсайдерська схема на $2,6 млн: обшуки в Samsung шокували технологічний ринок

    Одна з найбільших технологічних компаній світу опинилася в центрі масштабного розслідування. Прокуратура Південної Кореї провела обшуки в офісах Samsung Electronics у межах справи про можливу інсайдерську торгівлю, пов’язану з придбанням робототехнічної компанії Rainbow Robotics. Слідчі перевіряють інформацію про те, що керівники та співробітники компанії могли заробити мільйони доларів, використовуючи закриті дані про майбутню угоду із Samsung.

    Про це повідомляють південнокорейські ЗМІ та профільні технологічні видання з посиланням на прокуратуру Південного округу Сеула.

    Розслідування стосується подій, які передували повному поглинанню Rainbow Robotics компанією Samsung Electronics. Правоохоронці підозрюють, що окремі посадовці могли заздалегідь знати про майбутню угоду та використати цю інформацію для купівлі акцій або проведення фінансових операцій, які принесли їм значний прибуток після зростання вартості компанії.

    За попередніми даними, під підозрою перебувають 16 осіб. Серед них називають генерального директора Rainbow Robotics та фінансового директора компанії. За версією слідства, у період із 2022 по 2024 рік вони могли отримати незаконний дохід у розмірі від 3 до 4 мільярдів південнокорейських вон, що еквівалентно приблизно 1,9–2,6 мільйона доларів США.

    Слідчі вважають, що посадовці могли скористатися конфіденційною інформацією про плани Samsung щодо розширення присутності на ринку робототехніки та майбутнє придбання Rainbow Robotics. Якщо ці підозри підтвердяться, йтиметься про порушення Закону Південної Кореї про ринок капіталу та фінансові інвестиції.

    Під час обшуків правоохоронці вилучили документи, електронні носії інформації та внутрішню корпоративну переписку. Наразі триває аналіз отриманих матеріалів.

    Історія Rainbow Robotics привертає особливу увагу через її значення для майбутньої стратегії Samsung. Компанію було засновано дослідниками Корейського інституту передових технологій (KAIST), які брали участь у створенні першого корейського людиноподібного робота HUBO. З моменту заснування Rainbow Robotics стала одним із найперспективніших виробників роботизованих систем у країні.

    Компанія спеціалізується на створенні широкого спектра роботів: від колаборативних роботів для промисловості до сервісних систем, які можуть працювати в ресторанах, кафе та готелях. Окремий напрямок діяльності — розробка чотириногих роботів і гуманоїдних платформ для оборонного сектору, патрулювання та роботи в небезпечних умовах.

    Samsung почала активно інвестувати в Rainbow Robotics ще у 2023 році. Тоді технологічний гігант придбав значний пакет акцій компанії, а згодом поступово збільшував свою частку. У 2025 році Samsung остаточно отримала контроль над Rainbow Robotics, зробивши її своєю дочірньою структурою.

    Аналітики називають це придбання одним із найважливіших кроків Samsung на шляху до нової технологічної революції. Якщо протягом останніх десятиліть компанія асоціювалася переважно зі смартфонами, побутовою технікою та напівпровідниками, то тепер вона активно готується до епохи роботизації та штучного інтелекту.

    Особливий інтерес викликає проєкт гуманоїдного робота RB-Y1, який Rainbow Robotics представила останніми роками. Машина здатна пересуватися на колесах, виконувати складні маніпуляції руками та взаємодіяти з навколишнім середовищем за допомогою систем штучного інтелекту.

    Раніше Samsung вже заявляла про намір масштабно інтегрувати роботів і агентний штучний інтелект у власне виробництво до 2030 року. Компанія розраховує створити так звані «розумні фабрики майбутнього», де значна частина виробничих процесів буде автоматизована за допомогою робототехнічних комплексів нового покоління.

    Саме тому нинішній скандал привернув величезну увагу інвесторів. Будь-які розслідування, пов’язані з інсайдерською торгівлею, можуть впливати на довіру ринку та викликати додаткові питання до корпоративного управління компаній.

    Водночас експерти наголошують, що наразі підозри стосуються окремих посадовців Rainbow Robotics, а не самої Samsung Electronics як корпорації. Представники компанії поки не коментували деталі розслідування, заявивши лише про готовність співпрацювати зі слідством.

    Для світового ринку робототехніки ця історія має особливе значення. За прогнозами міжнародних консалтингових агентств, обсяг ринку роботів та автоматизованих систем до кінця десятиліття може перевищити сотні мільярдів доларів. Провідні технологічні компанії — від Tesla та Nvidia до Samsung і Hyundai — вже ведуть боротьбу за лідерство в новій галузі.

    На цьому тлі Rainbow Robotics розглядається як один із найцінніших активів азійського ринку робототехніки. Саме тому будь-які події навколо компанії миттєво привертають увагу інвесторів та світових медіа.

    Наразі розслідування триває. Якщо підозри прокуратури підтвердяться, фігурантам може загрожувати не лише багатомільйонний штраф, а й кримінальна відповідальність. Водночас справа може стати одним із найбільших корпоративних скандалів у технологічній галузі Південної Кореї за останні роки.

    Поки слідчі аналізують вилучені матеріали, ринок уважно стежить за розвитком подій. Адже на кону — не лише репутація окремих менеджерів, а й майбутнє одного з найамбітніших робототехнічних проєктів сучасності.

  • Путін у паніці відключав власні камери: штучний інтелект відкрив несподівану «дірку» в безпеці Кремля

    Путін у паніці відключав власні камери: штучний інтелект відкрив несподівану «дірку» в безпеці Кремля

    Російські спецслужби були змушені тимчасово відключити частину спеціальної системи відеоспостереження, яка використовується для охорони Володимира Путіна та найближчого оточення. Причиною стала нова загроза, яка налякала Кремль більше, ніж традиційні кібератаки чи диверсійні операції. Йдеться про стрімкий розвиток штучного інтелекту, здатного перетворювати звичайні камери спостереження на потужний інструмент розвідки. Про це повідомляє Financial Times із посиланням на джерела, обізнані з ситуацією.

    За даними видання, тривогу в Москві викликала нещодавня операція проти вищого керівництва Ірану, під час якої ізраїльська розвідка використала масиви відеоданих із дорожніх камер Тегерана для відстеження пересувань високопоставлених чиновників. Саме після цього російські силовики почали термінову перевірку власних систем безпеки.

    Financial Times стверджує, що російські спецслужби навіть тимчасово зупинили роботу окремої спеціальної системи відеоспостереження, яка не пов’язана із загальноміською мережею камер Москви. Повернути її до роботи дозволили лише після додаткового аудиту та спроб максимально ізолювати систему від зовнішніх мереж і потенційного несанкціонованого доступу.

    Особливий страх у Кремлі викликав саме спосіб проведення операції проти іранського керівництва. За інформацією FT, ізраїльські спецслужби роками збирали інформацію з міської мережі камер Тегерана. Отримані дані дозволили створити так званий «патерн життя» — детальну карту переміщень, звичок, маршрутів охорони та контактів високопосадовців. У результаті розвідка змогла визначити точний час і місце проведення закритої наради за участю верхівки іранського режиму.

    Фахівці пояснюють, що сучасні алгоритми штучного інтелекту кардинально змінили можливості аналізу відеоінформації. Якщо раніше співробітникам спецслужб доводилося вручну переглядати години записів або використовувати обмежені системи розпізнавання облич, то нині алгоритми можуть аналізувати мільйони годин відео практично в реальному часі.

    Ба більше, нові технології здатні знаходити не лише конкретних людей або автомобілі. ШІ навчився визначати моделі поведінки. Наприклад, алгоритм може виявити людину, яка регулярно змінює зовнішність, користується різними транспортними засобами або часто з’являється поруч із певними об’єктами. Саме такі поведінкові закономірності дозволяють спецслужбам встановлювати зв’язки між людьми та прогнозувати їхні подальші дії.

    Financial Times зазначає, що новітні системи вже дозволяють працювати з відео майже так само, як із пошуковими системами. Аналітик може поставити текстовий запит на кшталт: «знайти всіх людей, які передавали пакети в певному районі протягом останнього місяця» або «показати автомобілі, які регулярно супроводжували конкретний кортеж». Раніше виконання подібного завдання могло займати тижні, тепер — лічені хвилини.

    Для Росії ця проблема має особливе значення. Країна створила одну з найбільших систем відеоспостереження у світі. Лише в Москві працюють сотні тисяч камер, багато з яких інтегровані з технологіями розпізнавання облич. Російська влада активно використовувала ці інструменти для контролю протестів, пошуку підозрюваних та стеження за громадянами. Тепер же виявилося, що ця ж система потенційно може стати джерелом інформації для іноземних спецслужб.

    Додатковим фактором занепокоєння стали численні випадки проникнення у російські цифрові системи. Західні медіа та аналітичні центри неодноразово повідомляли про успішні операції українських кіберфахівців та хакерських груп, які отримували доступ до внутрішніх російських ресурсів. На цьому тлі навіть добре захищені мережі відеоспостереження почали розглядатися як потенційна вразливість.

    Експерти вважають, що історія з Кремлем демонструє глобальну зміну правил гри у сфері безпеки. Ще кілька років тому масове відеоспостереження сприймалося як перевага держави над громадянами. Сьогодні ж величезні мережі камер можуть обертатися проти самих урядів, якщо доступ до них отримують професійні розвідки або кібероператори, оснащені сучасними інструментами штучного інтелекту.

    Втім, аналітики наголошують, що навіть найсучасніші системи мають свої обмеження. Технології не гарантують стовідсоткової точності та можуть помилятися через зміну зовнішності, погану якість відео або використання елементарних засобів маскування. Однак швидкість обробки даних та можливість автоматичного аналізу величезних масивів інформації вже зараз роблять штучний інтелект одним із найпотужніших інструментів сучасної розвідки.

    Саме тому історія з тимчасовим відключенням систем охорони Путіна стала показовим сигналом для всіх спецслужб світу. Кремль, який роками будував одну з наймасштабніших систем цифрового контролю, раптом усвідомив, що в епоху штучного інтелекту навіть власні камери можуть стати небезпечними.

  • «Чат мертвий»: OpenAI готує радикальне перезавантаження ChatGPT

    «Чат мертвий»: OpenAI готує радикальне перезавантаження ChatGPT

    Американська технологічна компанія OpenAI готує найбільшу трансформацію ChatGPT з моменту запуску сервісу наприкінці 2022 року. Згідно з інформацією Financial Times, компанія планує радикально змінити концепцію свого найвідомішого продукту, перетворивши його з популярного чат-бота на повноцінну платформу цифрових помічників та агентів штучного інтелекту, які зможуть виконувати реальні завдання від імені користувачів. Цей крок розглядається як ключовий елемент нової стратегії OpenAI, яка прагне забезпечити довгострокове зростання доходів, зміцнити свої позиції на ринку та підготуватися до можливого виходу на фондову біржу.

    За останні кілька років ChatGPT став одним із найвідоміших технологічних продуктів у світі. Після запуску у листопаді 2022 року сервіс буквально змінив ставлення суспільства до штучного інтелекту. Якщо раніше технології ШІ залишалися переважно інструментами для вузького кола фахівців, то ChatGPT зробив їх масовими та доступними для сотень мільйонів людей. Саме OpenAI стала компанією, яка фактично запустила глобальний бум генеративного штучного інтелекту, змусивши технологічних гігантів по всьому світу вкладати мільярди доларів у розвиток аналогічних систем.

    Однак успіх ChatGPT приніс компанії не лише популярність, а й нові виклики. Попри величезну аудиторію, яка, за даними видання, вже наближається до одного мільярда користувачів, OpenAI продовжує витрачати колосальні кошти на розвиток своїх моделей. Навчання сучасних систем штучного інтелекту вимагає величезних обчислювальних потужностей, дорогих графічних процесорів, будівництва центрів обробки даних та постійного вдосконалення інфраструктури. На цьому тлі інвестори дедалі частіше очікують від компанії не лише технологічних проривів, а й чіткої стратегії виходу на стабільну прибутковість.

    Саме тому керівництво OpenAI почало переглядати роль ChatGPT у власній екосистемі. Якщо раніше продукт сприймався як інструмент для спілкування зі штучним інтелектом, то тепер його дедалі більше розглядають як своєрідний вхідний портал до ширшого набору сервісів. Усередині компанії формується бачення ChatGPT як універсального цифрового центру, який поєднуватиме різноманітні інструменти для роботи, навчання, програмування, управління завданнями та автоматизації бізнес-процесів.

    Одним із головних напрямків майбутньої трансформації стане розвиток агентів штучного інтелекту. На відміну від звичайних чат-ботів, які переважно відповідають на запити користувачів, агенти здатні самостійно виконувати складні багатокрокові дії. Вони можуть аналізувати інформацію, ухвалювати проміжні рішення, взаємодіяти з іншими сервісами та завершувати поставлені завдання без постійного контролю людини. Саме цей напрямок у OpenAI дедалі частіше називають наступною великою еволюцією індустрії штучного інтелекту.

    У майбутньому такі системи можуть самостійно бронювати авіаквитки та готелі, координувати зустрічі, вести календарі, створювати презентації, працювати з електронною поштою, проводити аналіз документів, готувати звіти або виконувати складні робочі процеси у корпоративному середовищі. Іншими словами, йдеться про перехід від формату «запитання-відповідь» до формату «поставив завдання — отримав готовий результат».

    Особливе місце у новій стратегії відводиться продукту OpenAI Codex. Компанія має намір суттєво збільшити інвестиції в його розвиток, оскільки програмування вважається одним із найбільш перспективних напрямків застосування штучного інтелекту. В останні роки інструменти генерації коду стали одним із найшвидше зростаючих сегментів ринку ШІ. Великі корпорації дедалі активніше впроваджують такі рішення для автоматизації розробки програмного забезпечення, скорочення витрат та підвищення продуктивності команд.

    Саме тому OpenAI поступово зміщує акценти від універсального чат-бота до систем, які здатні виконувати реальну роботу. Показовою стала заява одного зі старших співробітників компанії, якого цитує Financial Times: «Чат мертвий». Ця фраза стала відображенням настроїв усередині OpenAI, де все більше фахівців переконані, що традиційна модель спілкування з чат-ботом уже досягла своєї природної межі розвитку. Наступний етап полягає в тому, щоб штучний інтелект не просто надавав інформацію, а діяв самостійно та приносив практичну користь.

    Такі зміни відбуваються на тлі дедалі жорсткішої конкуренції в галузі. Одним із головних суперників OpenAI залишається Anthropic, яка активно розвиває власну модель Claude та поступово завойовує дедалі більшу частку корпоративного ринку. Водночас значні ресурси у сферу штучного інтелекту вкладають також Google, Microsoft, Meta та інші технологічні гіганти. Конкуренція між ними вже давно вийшла за межі створення найпотужнішої мовної моделі й дедалі більше концентрується навколо побудови цілих екосистем продуктів та сервісів.

    Ще кілька років тому головним завданням OpenAI було переконати людей у можливостях генеративного штучного інтелекту. Сьогодні ж перед компанією стоїть інша мета — перетворити ці технології на стабільний бізнес із прогнозованими доходами. Для цього необхідно створювати продукти, за які готові регулярно платити не лише окремі користувачі, а й великі компанії.

    Саме корпоративний сегмент розглядається як ключове джерело майбутніх прибутків. Бізнес-клієнти потребують інструментів для автоматизації процесів, роботи з великими масивами даних, управління документацією та підвищення ефективності співробітників. Агенти штучного інтелекту, здатні виконувати комплексні завдання без участі людини, потенційно можуть стати одним із найдорожчих і найприбутковіших продуктів на ринку.

    Аналітики зазначають, що якщо OpenAI реалізує свої плани, це може стати найбільшою зміною в історії ChatGPT та одним із найважливіших етапів розвитку всієї індустрії штучного інтелекту. Фактично компанія прагне створити універсального цифрового помічника, який стане невід’ємною частиною повсякденного життя мільйонів людей та робочих процесів тисяч компаній. Якщо раніше користувачі зверталися до ChatGPT за відповідями на запитання, то в майбутньому вони можуть доручати йому виконання повноцінних завдань, залишаючи штучному інтелекту дедалі більше функцій.

    Таким чином OpenAI готує не просто оновлення свого найпопулярнішого продукту, а масштабну трансформацію всієї концепції взаємодії людини зі штучним інтелектом. І саме від успішності цієї стратегії може залежати не лише майбутнє компанії, а й подальший розвиток глобального ринку ШІ, який уже зараз оцінюється у сотні мільярдів доларів і продовжує зростати рекордними темпами.

  • Кожен шостий айтівець залишився без роботи: кого скорочують найчастіше та чому ШІ поки не винен

    Кожен шостий айтівець залишився без роботи: кого скорочують найчастіше та чому ШІ поки не винен

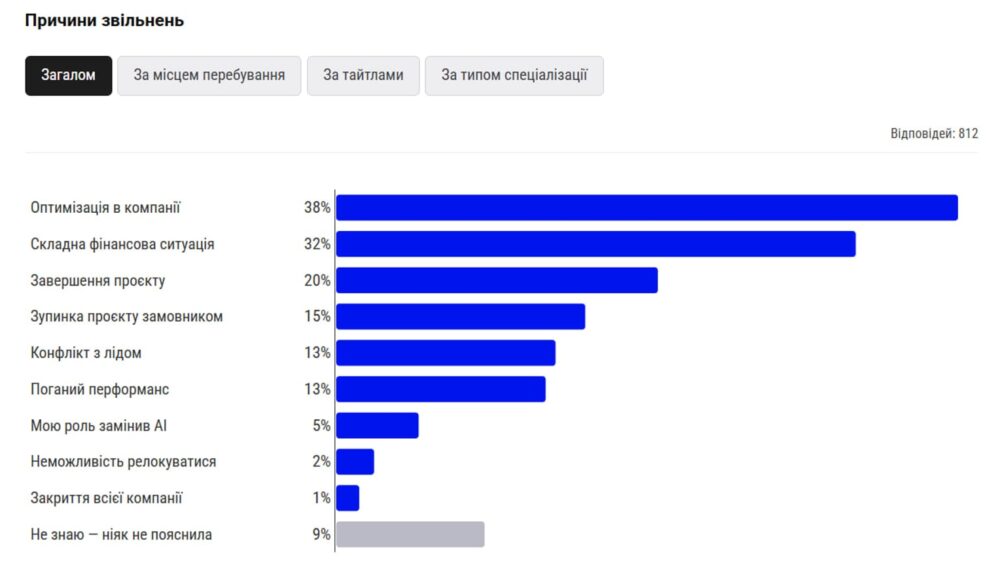
    Попри поступову стабілізацію українського ІТ-ринку, проблема скорочень персоналу залишається актуальною. За останній рік роботу втратив майже кожен шостий український ІТ-фахівець. Водночас поширене припущення про те, що причиною масових звільнень стає штучний інтелект, поки що не знаходить підтвердження у статистиці. Лише 5% звільнених спеціалістів заявили, що їхні функції були замінені AI-рішеннями.

    Про це свідчать результати масштабного дослідження DOU, у якому взяли участь понад 3800 українських ІТ-фахівців різних спеціалізацій та рівнів, а також понад 650 початківців, які перебувають у пошуку першої роботи в галузі.

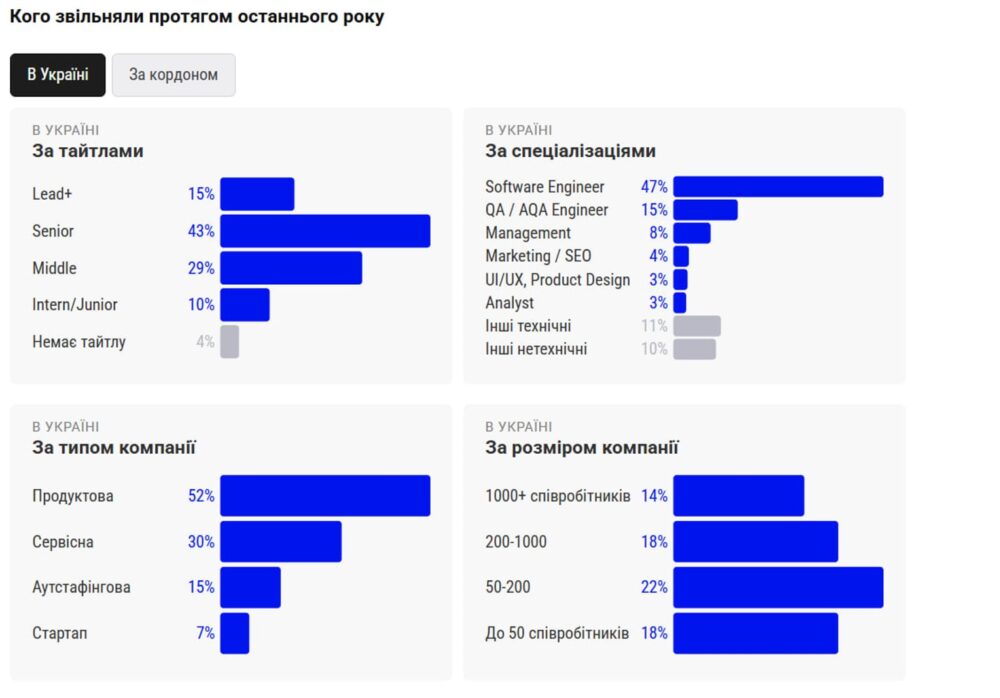
    Згідно з результатами опитування, у 2025 році під скорочення потрапили 17% українських айтівців. Для порівняння, роком раніше цей показник становив 19%. Хоча ситуація дещо покращилася, ринок праці продовжує перебувати під тиском економічних викликів, зниження інвестиційної активності та зміни структури попиту на спеціалістів.

    Дослідження показало, що за кордоном українських ІТ-фахівців звільняли навіть частіше, ніж в Україні. Серед спеціалістів, які працюють за межами країни, про втрату роботи повідомили 20% респондентів. Це свідчить про те, що глобальна технологічна галузь також переживає період трансформації та оптимізації витрат.

    Найчастіше під скорочення потрапляли досвідчені фахівці. Серед звільнених за кордоном понад половину становлять Senior-спеціалісти. В Україні їхня частка також залишається високою — 43%. Крім того, помітно зросла кількість скорочень серед фахівців рівня Lead та вище. Якщо у попередньому дослідженні вони становили 9% серед звільнених, то нині цей показник досяг 15%.

    Експерти DOU відзначають, що компанії дедалі частіше оптимізують управлінські та висококваліфіковані позиції, прагнучи скоротити витрати в умовах нестабільного ринку. Водночас частка звільнених Middle-спеціалістів поступово зменшується.

    Скорочення торкнулися практично всіх професійних напрямів. Серед технічних спеціалістів основними причинами звільнення стали завершення проєктів, відсутність нових замовлень або припинення фінансування. Нетехнічні працівники частіше повідомляли про оптимізацію штатів та реструктуризацію бізнесу.

    Особливо помітними скорочення були в компаніях середнього розміру, де працюють від 50 до 200 співробітників. Водночас звільнення фіксувалися як у невеликих стартапах, так і у великих міжнародних корпораціях.

    Головними причинами втрати роботи залишаються оптимізація бізнес-процесів та фінансові труднощі компаній. Саме ці фактори назвали 38% та 32% опитаних відповідно. Це свідчить про те, що ІТ-ринок все ще відчуває наслідки глобального уповільнення економіки та скорочення інвестицій у технологічний сектор.

    Окрему увагу дослідники приділили впливу штучного інтелекту на зайнятість. Попри численні прогнози щодо масового витіснення працівників алгоритмами, наразі цей процес залишається обмеженим. Лише 5% звільнених респондентів повідомили, що втратили роботу через впровадження AI-рішень або автоматизацію своїх функцій.

    Фахівці зазначають, що штучний інтелект поки що радше змінює характер роботи спеціалістів, ніж повністю замінює їх. Більшість компаній використовують AI як інструмент підвищення продуктивності, а не як повноцінну альтернативу працівникам.

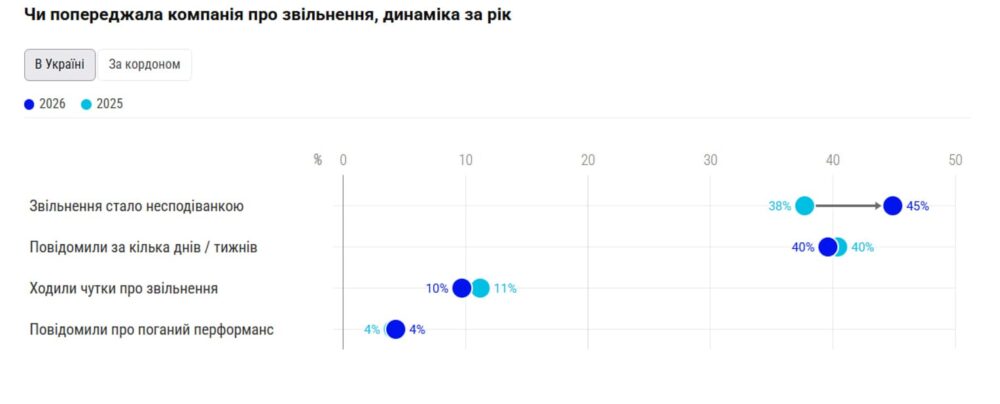
    Цікаво, що майже половина звільнених айтівців не очікувала скорочення. Для 44% респондентів новина про втрату роботи стала повною несподіванкою. В Україні таких випадків навіть побільшало — з 38% до 45% за рік. Лише 41% працівників отримали попередження про звільнення за кілька днів або тижнів до припинення співпраці.

    Щодо фінансових розрахунків, більшість роботодавців виконували свої зобов’язання перед працівниками. Повний розрахунок отримали 66% звільнених спеціалістів в Україні та 64% за кордоном. Водночас понад чверть працівників отримали лише заробітну плату без додаткових компенсацій або виплат за невикористану відпустку.

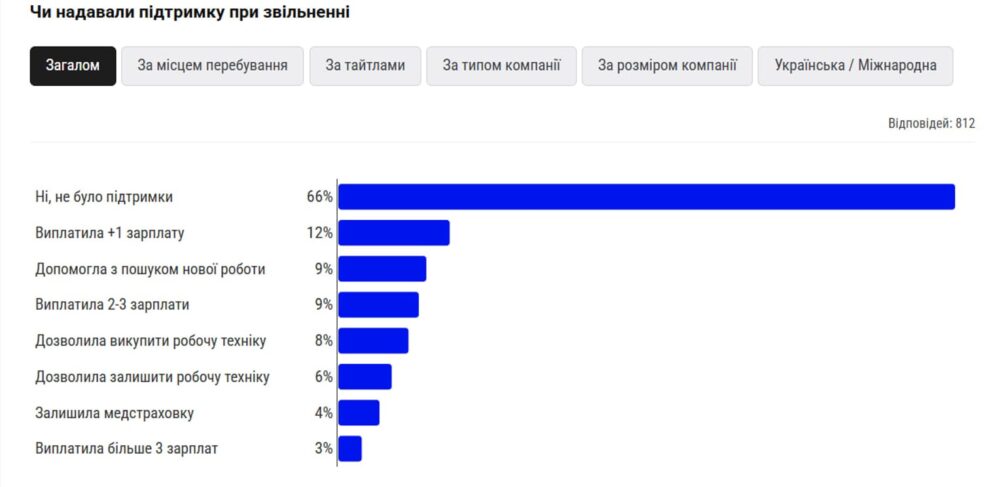
    Найбільш проблемною залишається тема підтримки працівників після звільнення. За даними DOU, 66% айтівців не отримали від роботодавця жодної додаткової допомоги. Лише 12% компаній виплачували додаткову зарплату після скорочення, 9% надавали компенсацію в розмірі двох-трьох окладів, а ще 9% допомагали зі пошуком нової роботи.

    Експерти зазначають, що найменше підтримки отримують молоді спеціалісти та працівники середнього рівня. Натомість фахівці рівня Lead і вище частіше можуть розраховувати на компенсаційні пакети та додаткові виплати.

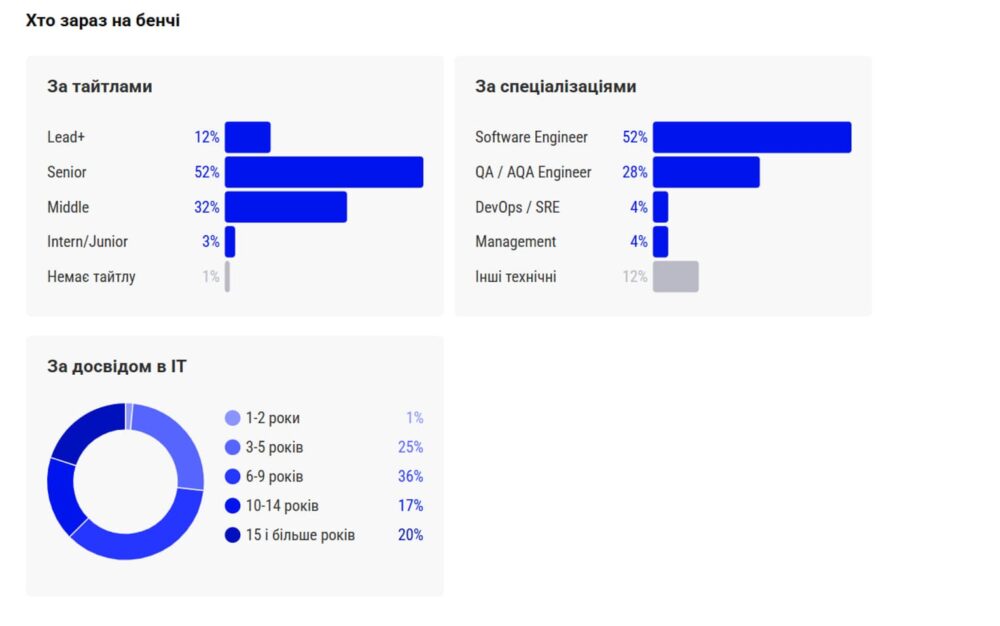
    Попри складну ситуацію, деякі показники свідчать про поступове оздоровлення ринку. Частка спеціалістів на так званому «бенчі» — коли працівник залишається в компанії без активного проєкту — знизилася до менш ніж 2%. Для порівняння, у 2023 році цей показник досягав 4%.

    Аналітики вважають, що український ІТ-сектор продовжує адаптуватися до нових умов. Основними викликами залишаються пошук нових замовлень, конкуренція за міжнародні контракти, кадровий дефіцит у деяких напрямках та поступова інтеграція інструментів штучного інтелекту у робочі процеси. Водночас результати дослідження демонструють, що головною причиною скорочень поки залишаються економічні фактори, а не технологічна революція, про яку часто говорять останніми роками.